OceanBase 4.3.5 引入了「堆表(HEAP ORGANIZED TABLE)」,这是这套存储引擎第一次把「索引组织表」作为默认范式之外,又给出了一种可选的行存布局。很多人第一反应是「不就是没有主键索引的普通表吗」,但翻一遍源码会发现它改的东西远比「建不建索引」更深:用户主键被降级成了一棵独立的唯一索引,主表的 rowkey 换成了一个隐藏的自增列。这篇文章从源码层面把这件事讲清楚,并对照说明它对查询、写入和功能支持上的全部影响。
## 一、组织模式:一个枚举、两个开关
存储组织方式在 OceanBase 里被抽象成一个显式的枚举:
“`cpp
enum ObTableOrganizationMode {
TOM_INDEX_ORGANIZED = 0, // 索引组织表(默认)
TOM_HEAP_ORGANIZED = 1, // 堆表
};
“`
建表语句里只要写 `ORGANIZATION = HEAP` 就会走堆表分支。解析逻辑在 `resolve_table_organization()` 里,有三条硬约束值得记住:
1. **只有 MySQL 模式支持**。`ORGANIZATION = HEAP` 在 Oracle 模式下会直接报 `NOT_SUPPORTED`;
2. **建表时决定,之后不可改**。`ALTER TABLE … ORGANIZATION` 会被拒绝,堆表就是建表那一刻的承诺;
3. **租户级开关** `default_table_organization` 控制默认形态(默认 `INDEX`)。想让整个租户默认建堆表,需要把它设成 `HEAP`,而这一步会先调用 `ObLicenseUtils::check_olap_allowed()` —— 也就是需要 OLAP 类型的 License 授权,否则设置失败。
换句话说,堆表不是一个随便能开的开关,它是面向分析型负载的一套独立存储形态。
## 二、结构差异:主键不再是行地址
这是整篇文章的核心。看下面这张对比图:
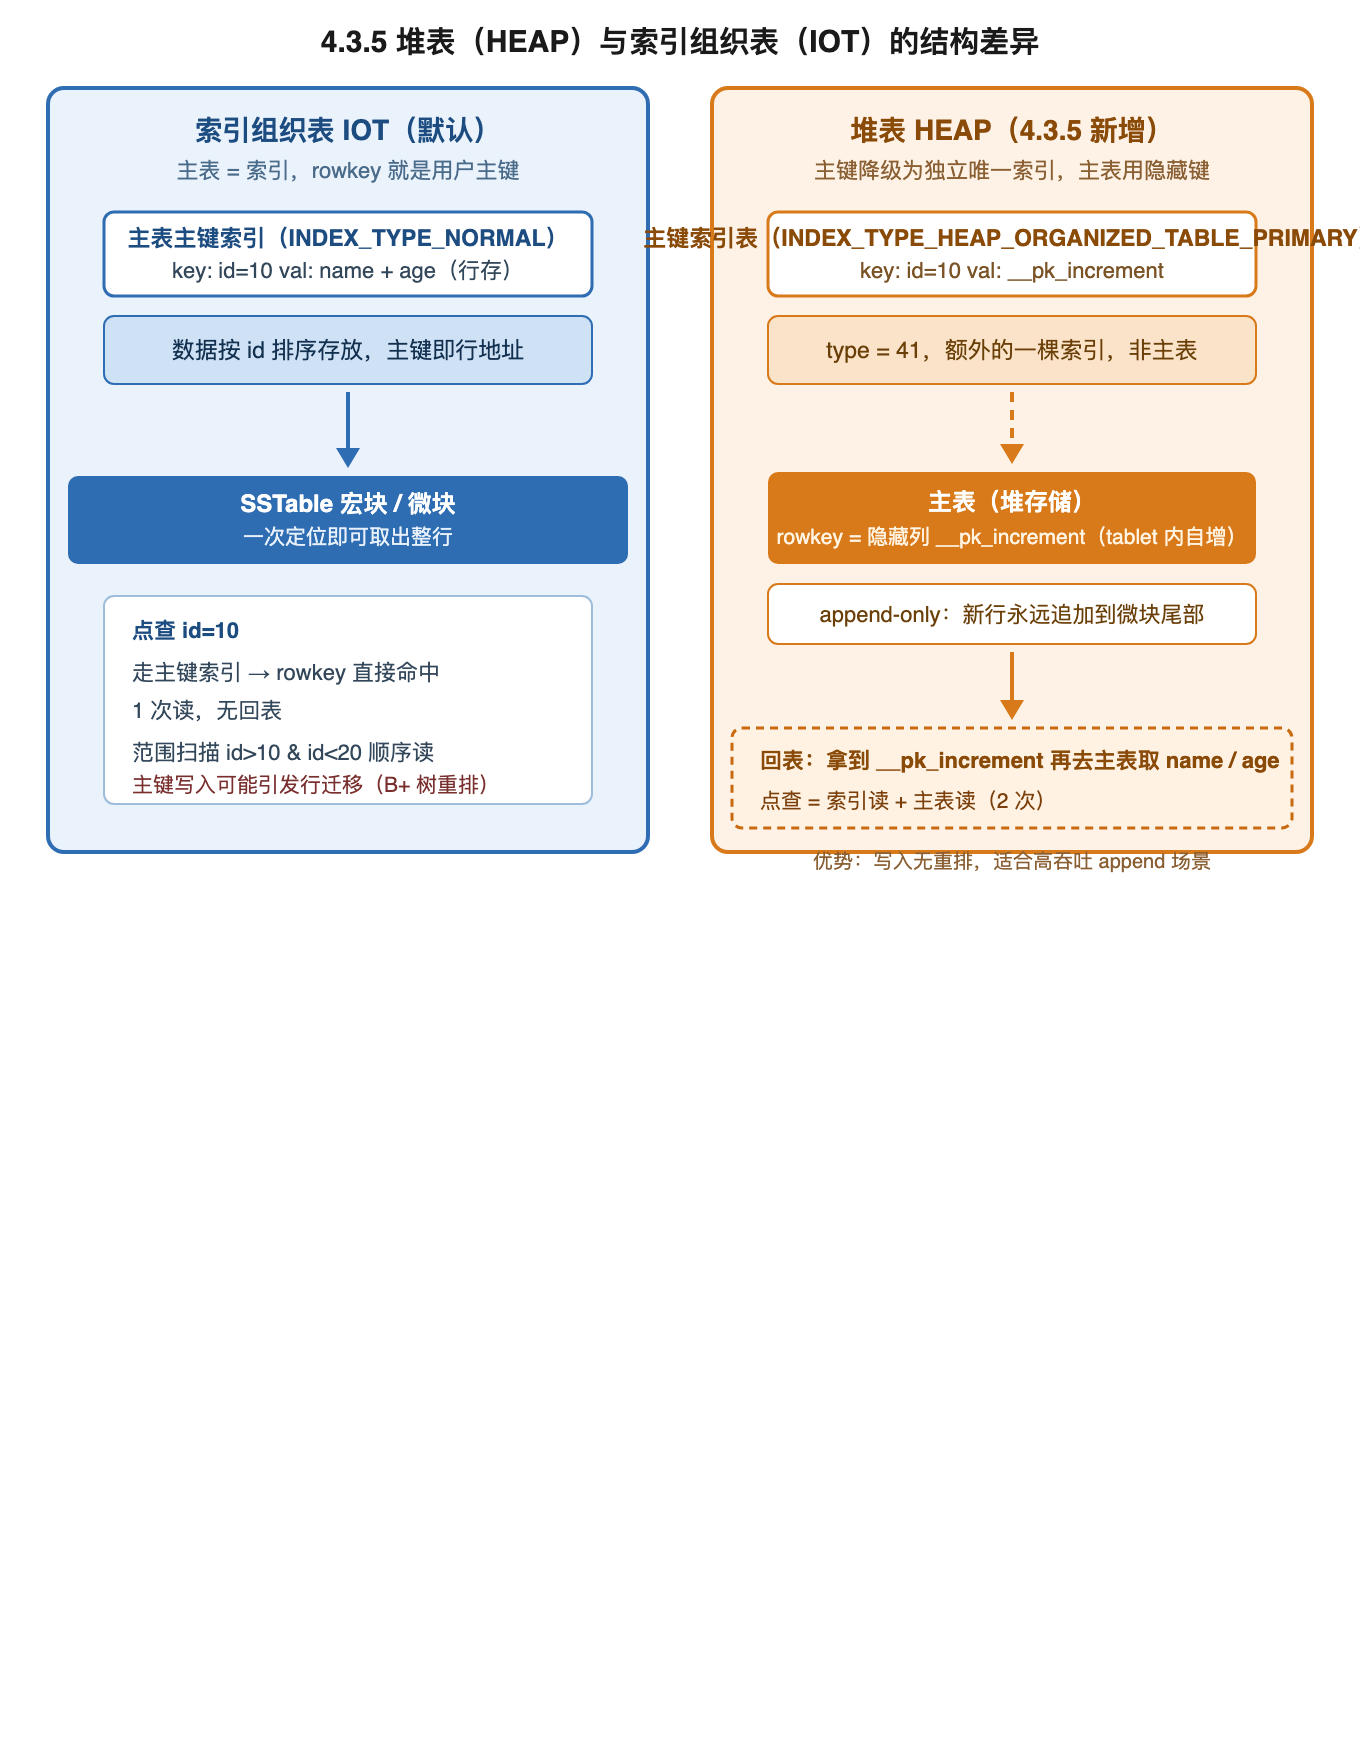
### 索引组织表(IOT,默认)
– 主表本身就是一棵主键索引树,**rowkey 就是用户主键列**;
– `id = 10` 这一行在存储里的位置直接由主键决定,取一行就是一次定位;
– 范围扫描 `id > 10 and id < 20` 是顺序读;
– 代价是:主键值乱序插入时行会「迁移」,B+ 树需要重排,写放大明显。
### 堆表(HEAP)
– 用户主键**被搬出去变成一棵独立索引**,索引类型是 `INDEX_TYPE_HEAP_ORGANIZED_TABLE_PRIMARY`(取值 41),它只是索引列表里的一分子,PRIMARY KEY 不再指向主表本身;
– 主表的 rowkey 换成了隐藏列 `__pk_increment`(内部列 ID = 1,列名为 `__pk_increment`),这是一个 **tablet 级自增**值;
– 数据按 `__pk_increment` **追加(append-only)**写入,新行永远落在微块尾部,不做重排;
– 代价是:点查 `id = 10` 时先在主键索引里拿到 `__pk_increment`,再拿它去主表取 `name / age` —— **多一次回表**。
源码在建表解析阶段就把这套结构拼好了,关键分支在 `ob_create_table_resolver.cpp` 里:
“`cpp
if (!is_oracle_mode && is_organization_set_to_heap()) {
primary_key_set_in_heap_table = true;
uk_or_heap_table_pk_add_to_index_list(…); // 主键进索引列表
column.add_column_flag(HEAP_TABLE_PRIMARY_KEY_FLAG); // 打标记 1<<30
column.set_nullable(false);
}
// 索引类型
type = INDEX_TYPE_HEAP_ORGANIZED_TABLE_PRIMARY;
“`
`HEAP_TABLE_PRIMARY_KEY_FLAG`(值为 `1 << 30`)是「这个主键列其实不是 rowkey,只是个普通索引列」的标记。优化器、执行计划、rowid 计算全靠这个标记来分辨 IOT 和 HEAP。
## 三、性能上到底差在哪
| 场景 | IOT(索引组织表) | HEAP(堆表) |
| — | — | — |
| 点查(主键等值) | 1 次读,主键即行地址 | 2 次读:索引 + 回表 |
| 主键范围扫描 | 顺序读,缓存友好 | 先扫索引再回表,随机性上升 |
| 主键乱序写入 | 行迁移 / B+ 树重排,写放大 | append-only,几乎无写放大 |
| 全表扫描 | 按主键序,读到即有序 | 按 `__pk_increment` 序(插入序) |
| 更新主键列 | 原地更新 | 走索引维护 + 行定位,代价更高 |
一句话概括这个 trade-off:**IOT 用一点写放大换来了主键上的读效率,HEAP 用一点读放大换来了写入的极致顺序**。所以堆表的定位非常明确 —— 高吞吐追加写入的 OLAP / 日志 / 明细场景,而不是 OLTP 点查主战场。
## 四、功能限制:这些语法会直接报错
堆表为了实现「追加写入」的简洁性,砍掉了一批跟主键强绑定的能力,源码里都有明确的拦截点:
1. **不支持 PDML**(`ob_optimizer.cpp`)。堆表上的 `INSERT … ON DUPLICATE KEY UPDATE` / `REPLACE` 这类语义无法生效,因为主键不再是主表的定位键,重复判断会失去意义;
2. **不支持 `DROP PRIMARY KEY`**(`ob_alter_table_resolver.cpp`)。主键索引是堆表结构的一部分,删掉它会让整个存储模型失效;
3. **不支持更新主键列**。`HEAP_TABLE_PRIMARY_KEY_FLAG` 那个列位不可变,改主键值没有合理落点;
4. **主键索引必须覆盖分区列**(`ob_resolver_utils.cpp`)。因为主键索引里只存了 `__pk_increment`,分区定位信息只能从主键本身推导,所以分区列必须在主键里;
5. **需要 4.3.5.1+ 版本**,且 OLAP 授权。
## 五、优化器与对外适配
结构变了,上层接口也得跟着变。最典型的是逻辑主键的推导:
“`cpp
// ob_table_schema.cpp —— 堆表与 IOT 在这里分叉
int ObTableSchema::get_logic_pk_column_ids(…)
{
if (is_heap_organized_table()) {
// 逻辑主键 = __pk_increment(隐藏自增列)
} else {
// 逻辑主键 = 用户主键列
}
}
“`
另外堆表的 rowid 被定义为 `(tablet id, rowkey)` 二元组(`ob_table_schema.cpp`),`PRI_KEY_FLAG` 的含义也随组织模式变化。对业务侧来说,这意味着:
– 堆表上不要依赖 `rowid` 的语义稳定性;
– `SHOW CREATE TABLE` 里看到的主键,跟实际存储顺序完全无关;
– 跨 tablet 的自增不共享 —— `__pk_increment` 是 **tablet 级**自增,单个 tablet 内部有序,全局不连续。
## 六、选型小结
– **默认继续用 IOT**。OLTP 业务、主键点查为主、主键基本单调自增 —— 索引组织表的读效率是现成的,没必要折腾。
– **考虑堆表**的场景:明细表 / 日志表 / 埋点表,写入 QPS 极高、主键是随机 UUID 之类(IOT 下行迁移严重)、查询以批量扫描为主而非点查。
– **先验证**:堆表要 OLAP 授权 + 4.3.5.1+,且 PDML 等一批能力会失效,上生产前务必用真实负载压测点查回表的那一次额外代价。
堆表不是「更简单的表」,而是 OceanBase 把存储引擎里「索引即数据」这条铁律,针对性地开了个口子:让一部分表干脆不要索引,只管往屁股后面追加。理解它的正确姿势,就是先理解它放弃了什么。
—
*本文基于 OceanBase 4.3.5_CE_BP6 源码阅读整理,对应代码:`ob_table_schema.h` / `ob_create_table_resolver.cpp` / `ob_create_table_resolver_base.cpp` / `ob_define.h` / `ob_table_schema.cpp` / `ob_optimizer.cpp` / `ob_alter_table_resolver.cpp` / `ob_resolver_utils.cpp`。*